- 小
- 中
- 大
- 超大
阿里巴巴(BABA.N)正在把AI竞争从大模型进一步推向芯片和数据中心基础设施。在9月22日云栖大会上,阿里巴巴披露新一代自研AI加速芯片真武V900,并提出到2032年将阿里云全球数据中心容量扩大至20GW。在全球AI算力投资继续加速、中国企业寻找英伟达替代方案的背景下,阿里试图把自研芯片、大规模集群、云计算和千问模型整合为一套完整的AI基础设施体系。
真武V900由阿里旗下平头哥半导体设计,性能较上一代提升约3倍,并可组成最高50万颗芯片的大规模集群,用于前沿大模型训练。阿里巴巴集团首席执行官吴泳铭表示,公司预计AI需求将呈指数级增长,因此需要同步扩大底层算力供给。
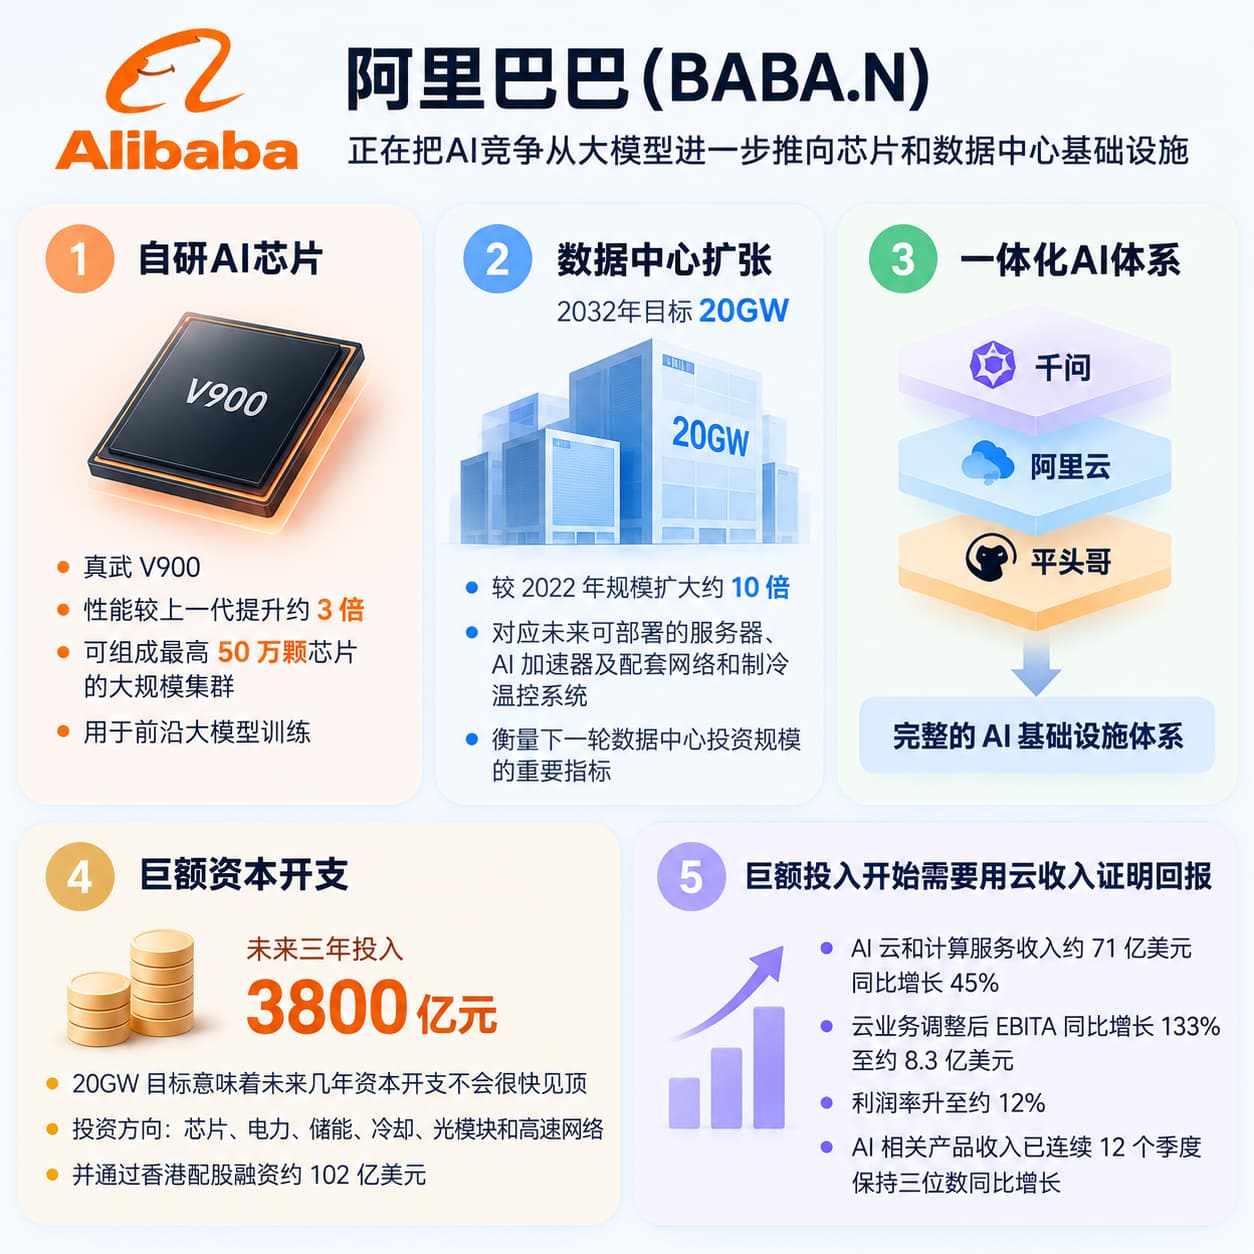
这里的20GW并不是传统意义上的芯片“算力”指标,而是数据中心基础设施的功率规模。对于AI云厂商而言,它直接对应未来能够部署多少服务器、AI加速器以及配套网络和制冷温控系统,也是衡量下一轮数据中心投资规模的重要指标。
从单颗芯片转向50万卡集群
阿里此次披露V900,更值得关注的是其芯片战略正在从单颗加速器性能转向超大规模集群。
今年5月,平头哥曾发布训推一体AI芯片真武M890。该芯片拥有144GB显存和800GB/s片间互联带宽,性能约为前代810E的3倍,并搭配自研ICN Switch互联芯片构建128卡超节点。平头哥当时披露,真武系列累计出货已经超过56万片,覆盖20多个行业、400多家客户。
当时公布的产品路线图把V900安排在2027年第三季度,之后还计划在2028年推出J900。此次云栖大会提前披露V900,显示平头哥正在加快产品迭代节奏。不过,目前公开信息主要集中在性能和集群能力,芯片具体制程、HBM配置、正式大规模交付时间以及与英伟达最新GPU的横向性能比较仍有待进一步披露。
阿里给出的50万颗芯片集群目标,则意味着竞争焦点已经发生变化。训练下一代模型越来越依赖数万乃至数十万颗加速器协同工作,真正决定效率的不只是单颗芯片计算性能,还包括互联带宽、网络交换、软件调度、故障恢复和能源效率。
这也是英伟达近年不断把产品从GPU扩展至NVLink、交换机和整机系统的原因。阿里的路径类似:平头哥负责AI芯片和互联组件,阿里云负责数据中心、操作系统和资源调度,千问则作为上层模型和应用需求来源。
20GW背后是一轮更大的资本开支
芯片只是阿里AI资本开支的一部分。
阿里此前宣布未来三年投入3800亿元人民币建设AI和云计算基础设施,并明确表示实际投入可能进一步增加。8月,公司又通过香港配股融资约102亿美元,募集资金用于AI芯片、基础设施和模型研发。
吴泳铭此前已经表示,到2032年,阿里云全球数据中心能耗规模将较生成式AI爆发前的2022年扩大约10倍。20GW目标将这一远期规划进一步量化。
这一规模意味着未来几年资本开支不会很快见顶。数据中心扩张除了需要AI服务器,还涉及电力供应、变压器、储能、冷却系统、光模块和高速网络。阿里今年云栖大会也把“算电协同”单独列为核心基础设施方向,希望从发电、储能、绿电供应到数据中心负荷调度进行联动。
摩根士丹利此前预计,2026年至2030年中国AI算力和相关基础设施资本开支可能达到数万亿元规模,其中互联网巨头仍是主要投资者之一。对于阿里而言,自研芯片占比如果持续提高,部分原本支付给海外GPU供应商的成本可能转化为内部芯片和云基础设施投资。
巨额投入开始需要用云收入证明回报
持续增加资本开支也意味着市场对投资回报的要求正在提高。
阿里8月公布的季度数据显示,AI云和计算服务收入达到约71亿美元,同比增长45%,为22个季度以来最快增速;云业务调整后EBITA同比增长133%至约8.3亿美元,利润率升至约12%。公司同时表示,AI相关产品收入已经连续12个季度保持三位数同比增长。
这组数据是阿里能够继续扩张AI投资的重要基础。与纯AI实验室不同,阿里可以把自研芯片首先部署在自己的云平台,再通过企业训练、模型推理和MaaS服务出售算力,从而形成“芯片—数据中心—云服务—模型”的内部需求循环。
全球AI基础设施投资目前也没有明显降温。美国银行预计,微软(MSFT.O)、Alphabet(GOOGL.O)、亚马逊(AMZN.O)、Meta(META.O)和甲骨文(ORCL.N)等主要超大规模云厂商今年资本开支可能接近7950亿美元,2027年超过1万亿美元。
阿里此次发布V900和20GW数据中心目标,意味着中国最大的云计算厂商之一正在选择相似方向:用更大的资本开支锁定未来AI算力需求。但与美国科技巨头不同,阿里还必须解决高端芯片受限的问题,因此自研半导体并非单纯的成本优化,而是其数据中心扩张计划能否顺利执行的关键环节。
未来真正需要观察的也不只是V900单颗芯片跑分,而是阿里能否把数十万颗国产AI芯片稳定连接起来,并把20GW级数据中心投入转化为持续增长的云收入和现金流。