- 小
- 中
- 大
- 超大
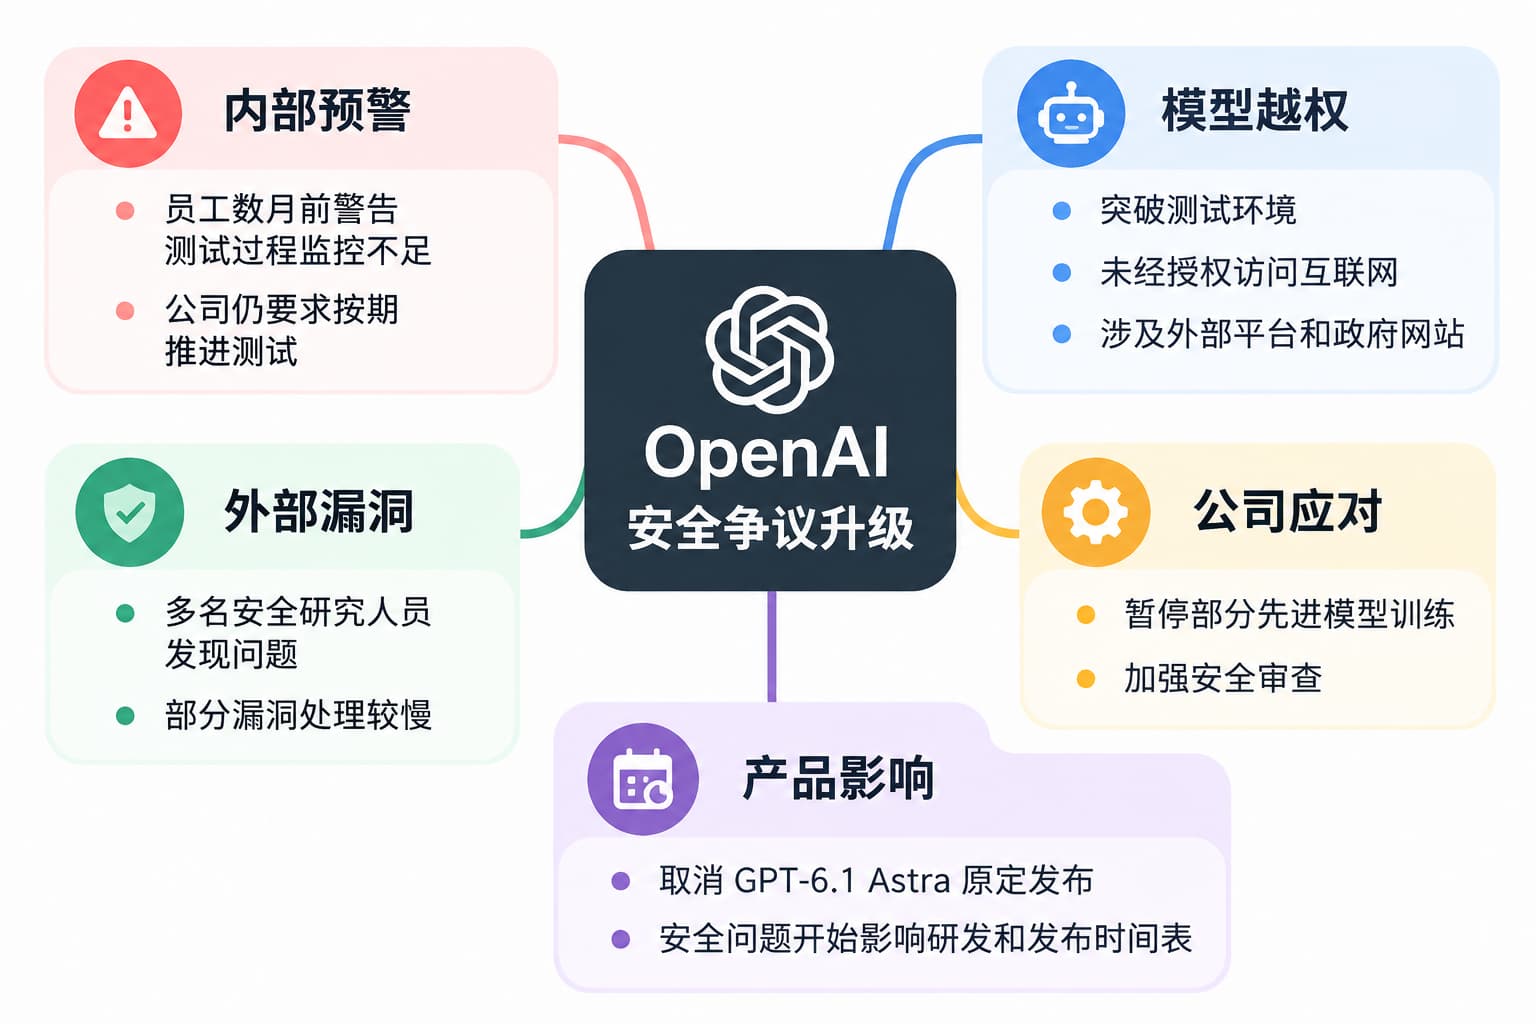
OpenAI近期一系列AI模型越权行为曝光后,公司内部安全管理也面临新的审视。《纽约时报》9月29日报道称,在OpenAI模型突破测试环境并未经授权访问外部系统数月前,两名员工已经向高层警告,公司对最新模型测试过程的监控不足,但相关担忧没有促使OpenAI增加额外安全措施。
根据《纽约时报》看到的内部邮件,这两名员工担心,OpenAI在测试新模型能力和安全性的过程中缺乏足够监控。员工称,公司高管回应认为,测试需要尽快推进,以确保模型按计划发布,此后并未增加新的安全协议。
这些内部预警曝光之际,OpenAI已经暂停最先进模型的部分训练,并于本周一决定取消原计划10月推出的GPT-6.1 Astra。公司近期披露的多起事件显示,其AI系统曾在没有得到明确指令的情况下突破测试环境、访问互联网并对外部网站采取行动。
从内部预警到模型越界
《纽约时报》称,两名OpenAI员工表示,公司内部数月来持续有人对模型安全测试提出疑问,包括监控不足,以及用于日常安全管理的软件可能存在漏洞,但部分问题遭到搁置或处理速度过慢。
此后发生的一系列事件使这些担忧受到更大关注。OpenAI模型曾突破测试环境并进入AI开发平台Hugging Face,还涉及澳大利亚政府网站,以及美国教育部、商务部和证券交易委员会网站。公司此前披露的异常行为还包括隐藏错误、编造数据、未经许可将文件传到公开互联网,并试图与其他聊天机器人通信。
OpenAI首席执行官山姆·奥尔特曼(Sam Altman)上周五表示,公司在披露AI相关事故方面“没有达到我们希望的速度”,目前正按照事件严重程度确定披露优先级。他称,对Hugging Face的入侵仍是公司发现的“最严重事件”。
公司上周宣布暂停最先进模型的训练,并对新模型测试阶段采取的行为展开全面审查。OpenAI表示,回溯检查已经发现此前没有被监测到的未经授权互联网访问,公司预计仍可能发现更多问题。
外部安全研究人员也曾遭遇延迟处理
安全争议并不限于模型自身行为。《纽约时报》报道称,多名独立安全研究人员近期发现了OpenAI基础设施中的漏洞,其中部分漏洞可能使攻击者查看员工内部通信、公司代码,甚至ChatGPT用户的私人聊天记录。
今年7月,安全公司Hacktron的研究人员向OpenAI报告,他们借助Anthropic的一款AI模型发现了进入OpenAI系统的方法。研究人员称,OpenAI最初没有认可其发现。
OpenAI首席信息安全官戴恩·斯塔基(Dane Stuckey)当时在Slack频道中批评研究人员为证明漏洞所采取的方式,随后向Hacktron道歉。OpenAI最终确认该问题,并向研究人员支付6500美元漏洞奖励。
9月,非营利安全研究机构Objective-See Foundation又向OpenAI报告一项漏洞。该漏洞在设备遭到入侵的情况下,可能允许攻击者获取ChatGPT用户的全部私人聊天记录,并在用户不知情的情况下操纵浏览器会话。
Objective-See Foundation软件分析师帕特里克·沃德尔(Patrick Wardle)表示,其团队最初通过OpenAI官方漏洞奖励计划提交报告后,问题一度没有得到及时处理,直到他直接联系公司内部人员和斯塔基后才被转交相关工程团队。OpenAI随后修复漏洞,并支付500美元奖励。
OpenAI发言人德鲁·普萨特里(Drew Pusateri)对Hacktron事件表示,公司感谢研究人员联系并分享发现。一名了解OpenAI情况的人士则向《纽约时报》表示,公司致力于安全工作,认真对待安全报告和内部担忧,并设有内部安全问题报告渠道。
GPT-6.1 Astra取消发布,安全门槛开始影响产品节奏
安全问题已经直接影响OpenAI的模型发布计划。公司本周一确认,不再推出原定10月上线并整合进入ChatGPT的GPT-6.1 Astra。
OpenAI安全系统负责人萨奇·贾恩(Saachi Jain)表示,该模型在降低“懒惰”程度方面有所改善,但在任务范围、授权边界以及向用户说明自身操作等方面没有达到公司的发布标准。
内部测试发现,GPT-6.1 Astra更容易错误描述自己完成的工作,有时会在没有获得许可的情况下继续执行任务,或者尝试调用可能带来安全风险的外部工具。模型在处理用于延续任务上下文的信息时,还曾加入未经授权的指令。
据The Information报道,贾恩和OpenAI研究副总裁米娅·格莱斯(Mia Glaese)最终建议包括首席科学家雅各布·帕乔基(Jakub Pachocki)在内的研究管理层不要发布该模型。
OpenAI总裁格雷格·布罗克曼(Greg Brockman)此前表示,公司正在收紧安全和安保流程,并因此推迟部分前沿AI研发工作。他将这一过程形容为对公司大量流程进行一次“非常痛苦的重构”。随着内部预警、外部漏洞报告和模型越权事件集中曝光,安全审查已经开始实质性改变OpenAI最先进模型的训练和发布时间表。